Miten LLM toimii teknisesti?
Luvussa 2 kävimme läpi laajahkon yleiskuvan kielimalleista. Nyt syvennymme siihen, mitä mallin sisällä tapahtuu matemaattisesti.
Suuri kielimalli (LLM) ei ymmärrä tekstiä ihmisen tavoin. Sen toiminta perustuu matemaattiseen optimointiin, vektorilaskentaan ja todennäköisyysjakaumiin. Tavoitteena on luoda selkeä intuitio siitä, miten teksti muuttuu numeroidun avaruuden kautta laadukkaaksi kieleksi.
1. Tokenointi — teksti muutetaan numeroiksi
Tietokoneet eivät käsittele kirjaimia tai sanoja, vaan tokeneita. Tokeni voi olla kokonainen sana, sanan osa tai yksittäinen merkki (kuten välimerkki tai koodin erikoismerkki).
Jokaiselle tokenille on määritelty oma kokonaisluku-ID mallin sanastossa (vocabulary).
Esimerkki sana-jakosta:
| Teksti | Token | Token-ID |
|---|---|---|
| "kissa" | "kis" | 15342 |
| "kissa" | "sa" | 981 |
Kielimallin syötteeksi ja tulosteeksi muotoutuu siten aina lista kokonaislukuja: [15342, 981].
2. Embedding-tila — tokenit muutetaan vektoreiksi
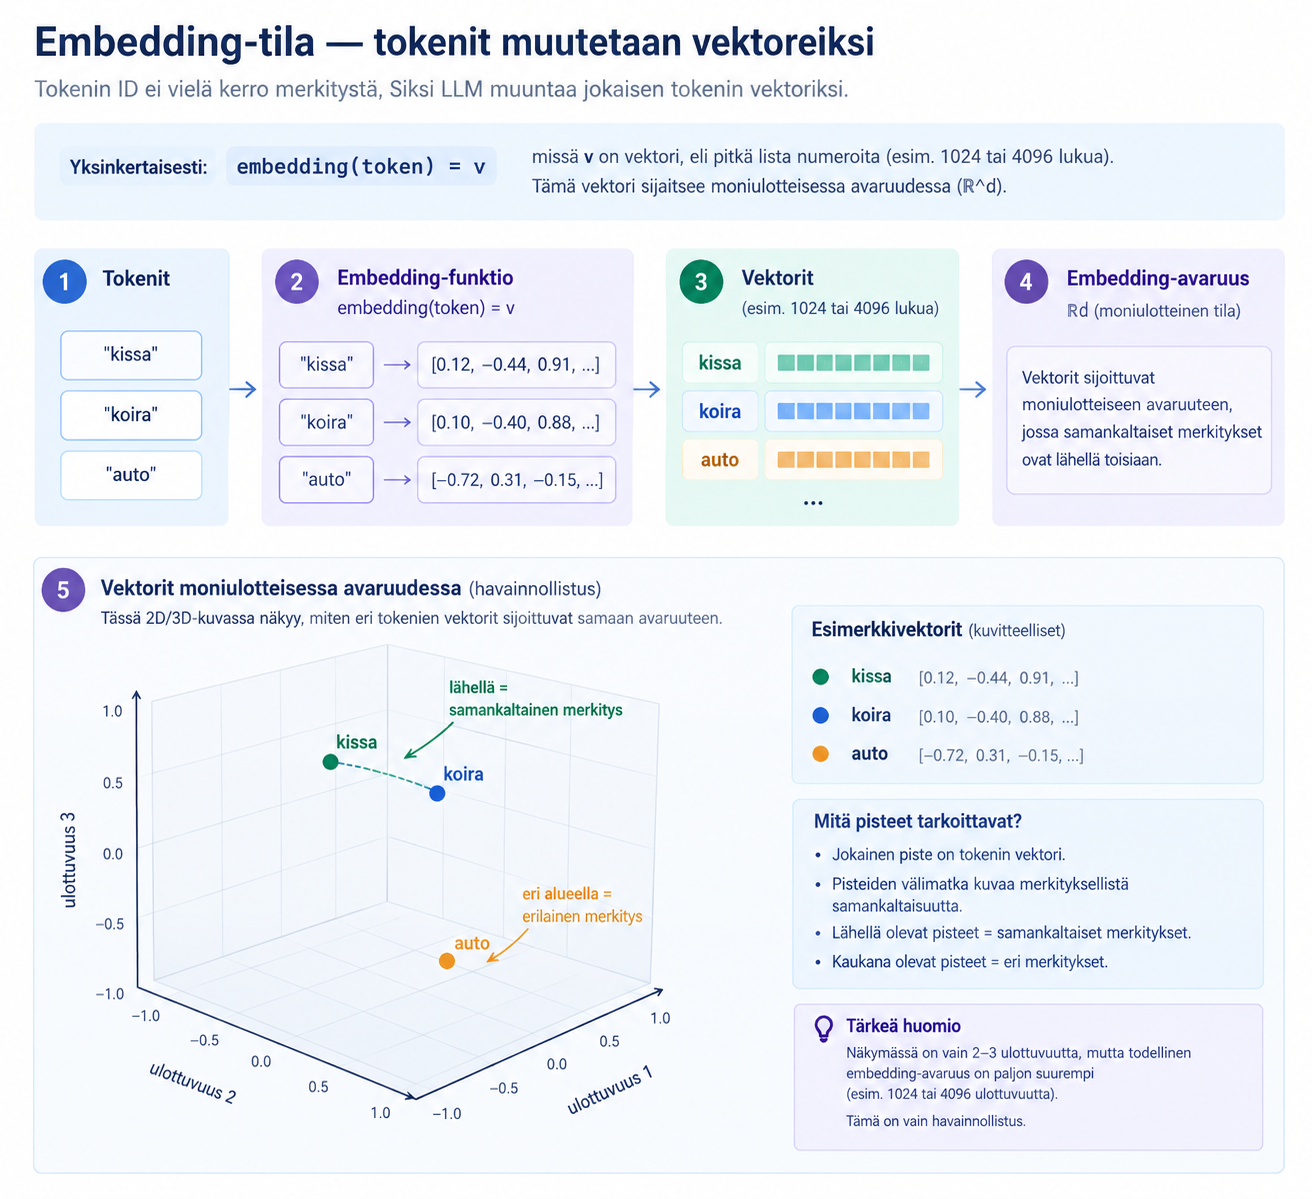
Pelkkä numero-ID (kuten kissa = 15342) ei vielä kerro mallille mitään sanan merkityksestä tai sen suhteesta muihin sanoihin. Tietokoneelle luvut 15342 ja 15343 ovat vain peräkkäisiä kokonaislukuja, vaikka ne edustaisivat sanoja "kissa" ja "lentokone".
Sanojen välisen merkityssuhteen koodaamiseksi jokainen token-ID muunnetaan vektoriksi eli moniulotteiseksi koordinaatiksi:
missä \(v\) on vektori (pitkä lista liukulukuja, tyypillisesti 4 096–12 288 lukua). Tämä vektori sijoittaa sanan moniulotteiseen merkitys- eli vektoravaruuteen (\(\mathbb{R}^d\)).
Vektoriavaruudessa samankaltaisia asioita edustavat sanat (kuten "kissa" ja "koira") päätyvät lähelle toisiaan, kun taas eri kontekstiin kuuluvat sanat (kuten "auto") sijoittuvat kauemmas.
Käsitepankki: Embedding (Vektorointi)
- Embedding-vektori: Numeerinen esitysmuoto, joka koodaa sanan perusmerkityksen koordinaateiksi moniulotteiseen avaruuteen.
- Avaruuden dimensio (\(d\)): Vektorin pituus (esim. 4 096 lukua), joka määrittää, kuinka monta eri merkitysominaisuutta malli voi koodata yhteen sanaan.
- Kosini-similaarisuus: Matemaattinen mittari, jolla arvioidaan kahden vektorin välistä kulmaa eli sanojen merkityksellistä läheisyyttä.
Haastavammat käsitteet havainnollistuvat vektoreina näin:
- "kissa" → [0.12, −0.44, 0.91, …]
- "koira" → [0.10, −0.40, 0.88, …]
- "auto" → [−0.85, 0.11, −0.32, …]
Jos kaksi vektoria osoittavat samaan suuntaan avaruudessa, niiden edustamat sanat ovat merkitykseltään lähellä toisiaan. Embedding-tila on siis matemaattinen kartta, jossa merkitykset ovat koordinaatteja.
3. Transformer-arkkitehtuuri — Attention-mekanismi
Pelkät embedding-vektorit koodaavat sanojen staattisen perusmerkityksen, mutta ne eivät vielä ota huomioon lauseen kontekstia. Esimerkiksi sana "kissa" tarkoittaa täysin eri asiaa lauseissa "Kissa istuu matolla" ja "Siltanosturin kissa liikkui kiskolla".
Transformer-arkkitehtuurin ydin on Attention-mekanismi (huomiomekanismi), joka mahdollistaa sanojen välisen vuorovaikutuksen. Se laskee, kuinka paljon painoarvoa eli huomiota kunkin sanan tulee kiinnittää lauseen muihin sanoihin, jotta sanalle muodostuu tilanteeseen sopiva kontekstisidonnainen vektori.
Attention perustuu matriisilaskentaan:
Kaavassa:
- Query (\(Q\)): Hakupyyntö eli mitä tietoa nykyinen sana etsii ympäristöstään.
- Key (\(K\)): Avain eli mitä tietoa muut lauseen sanat tarjoavat.
- Value (\(V\)): Arvo eli sanojen varsinainen tietosisältö, joka yhdistetään lopulliseen kontekstivektoriin saadun huomioarvon perusteella.
- \(\sqrt{d_k}\): Skalaustekijä, joka estää pistetulon kasvamisen liian suureksi suurilla vektorin dimensioilla.
Miten kaava toimii vaihe vaiheelta?
- Pistetulo (\(QK^T\)): Lasketaan yhteensopivuus eli "osuma" Queryn ja Keyn välillä. Mitä suurempi pistetulo on, sitä enemmän sanojen merkitykset liittyvät toisiinsa siinä kontekstissa (esim. sanojen koira ja haukkuu välille muodostuu suuri arvo).
- Skaalaus (\(\sqrt{d_k}\)): Tulos jaetaan avaimen dimension (\(d_k\)) neliöjuurella. Tämä estää arvojen kasvamisen liian suuriksi syvissä verkoissa ja pitää laskennan numeerisesti stabiilina.
- Softmax: Muuntaa saadut pistetulokset todennäköisyyksiksi (välille 0–1), joiden summa on aina 1 (100 %). Tämä muodostaa varsinaisen attention-painojakauman (huomiomietaulukon).
- Painotettu summa (\(\cdot V\)): Saadut painokertoimet kerrotaan Value-matriisilla (\(V\)). Lopputuloksena syntyy uusi vektori, joka yhdistää sanan oman perusmerkityksen ja ympäröivän kontekstin.
Käsitepankki: Attention-mekanismi
- Self-Attention (Itsehuomio): Mekanismi, jossa sarjan jokainen sana vertaa itseään samanaikaisesti kaikkiin muihin saman syötteen sanoihin.
- Query, Key, Value (Q, K, V): Hakukonevertaus: Query on hakusana, Key on tuloksen avainsana/otsikko ja Value on sivun varsinainen tietosisältö.
- Skaalattu pistetulo-attention: Laskentatapa, jossa yhteensopivuus lasketaan pistetulolla ja tasataan jakamalla vektorin pituuden neliöjuurella.
4. Mallin kerrokset — vektorien muokkausta
Transformer-mallissa on kymmeniä tai jopa satoja kerroksia. Jokaisen kerroksen tehtävänä on ottaa vastaan edellisen kerroksen tuottamat vektorit ja rikastaa niiden sisältämää informaatiota matemaattisilla muunnoksilla.
Vektorit eivät siis pysy samoina läpi verkon, vaan niiden arvot (koordinaatit numeroavaruudessa) muuttuvat kerros kerrokselta.
Käsitepankki: Peruskäsitteet
- Vektori (\(\vec{h}\)): Pitkä lista numeroita (esim. 4096 liukulukua), joka edustaa tiettyä tekstitokenia eli sanaa tai sen osaa.
- Representaatio: Vektorin numeerinen sisältö ja sen edustama "merkitys" tietyssä kerroksessa.
- Attention (Itsehuomio): Mekanismi, joka laskee vektorien välisiä suhteita ja siirtää toisiinsa liittyviä vektoreita lähemmäs toisiaan numeroavaruudessa.
Kerroksen matemaattinen rakenne
Jokainen Transformer-kerros suorittaa sarjan täsmällisiä matemaattisia operaatioita. Yksinkertaistettuna yhden kerroksen laskenta esitetään yhtälöllä: $\(\vec{h}_{i+1} = f(\text{Attention}(\vec{h}_i)) + g(\vec{h}_i)\)$
Yhtälön osat:
- \(\vec{h}_i\) = Kerroksen \(i\) syötevektori (edellisen kerroksen lopputulos).
- \(\text{Attention}(\vec{h}_i)\) = Huomiomekanismi, joka suhteuttaa syötevektorin kaikkiin muihin lauseen vektoreihin.
- \(f(\dots)\) = Feed-forward-verkko (FFN), joka tekee vektorille pistekohtaisia lineaarisia ja ei-lineaarisia muunnoksia.
- \(g(\vec{h}_i)\) = Residual-yhteys (skip-connection), joka tuo alkuperäisen syötteen sellaisenaan laskun lopputulokseen.
- \(\vec{h}_{i+1}\) = Kerroksen tulostevektori, joka siirtyy seuraavalle kerrokselle \(i+1\).
Mitä kerroksen sisällä tapahtuu?
Yksittäisessä kerroksessa suoritetaan järjestyksessä seuraavat vaiheet:
- Attention (Huomio): Vektorit suhteutetaan toisiinsa. Attention laskee, kuinka paljon kukin token vaikuttaa muihin tokeneihin ja seuraavan sanan ennustamiseen.
- Normalisointi: Laskennan numeeriset arvot vakautetaan, jotta verkon oppiminen pysyy tasaisena eikä numeroarvojen suuruus karkaa hallinnasta.
- Lineaariset muunnokset & Ei-lineaariset aktivaatiot (\(f\)): Vektoreille tehdään matriisituloja (lineaarisuus) ja niihin sovelletaan aktivaatiofunktioita (epälineaarisuus), jotta malli kykenee oppimaan monimutkaisia, ei-suoraviivaisia riippuvuuksia.
- Residual-yhteys (\(g\)): Osa edellisen kerroksen alkuperäisestä tiedosta yhdistetään suoraan uuteen tulokseen (\(+ g(\vec{h}_i)\)). Tämä estää alkuperäisen tiedon "unohtumisen" syvissä verkoissa.
Käsitepankki: Laskentavaiheet
- Feed-forward-verkko (\(f\)): Tiheä neuroverkkokerros, joka käsittelee jokaisen vektorin yksitellen ja poimii siitä syvempiä piirteitä.
- Ei-lineaarinen aktivaatiofunktio: Matemaattinen funktio (esim. GELU tai ReLU), joka mahdollistaa monimutkaisten syy-seuraussuhteiden mallintamisen pelkän suoran kertoimen sijaan.
- Residual-yhteys (\(g\)): "Oikopolku", joka lisää kerroksen syötteen sellaisenaan kerroksen tulokseen. Se takaa, että tieto virtaa vääristymättä satojen kerrosten läpi.
Informaation abstraktiotason kasvu
Verkon alussa vektorit edustavat vain yksittäisiä sanamuotoja. Mitä syvemmälle verkossa edetään, sitä enemmän vektoripisteet ryhmittyvät ja niiden sisältämä tieto muuttuu abstraktimmaksi:
Malli ei siis "aja ajatuksiaan" tai käsittele tietoa tekstinä, vaan se muokkaa vektoreiden koordinaatteja siten, että esimerkiksi kerroksella 40 jokainen vektori kantaa mukanaan koko tekstikontekstin ja syy-seuraussuhteet.
flowchart TB
    subgraph L0["1. Kerros 0: Syötevektorit (h₀)"]
        direction TB
        subgraph R1["Lause 1"]
            direction LR
            A1["1: kissa"] -.- A2["2: istuu"] -.- A3["3: matolla"]
        end
        subgraph R2["Lause 2"]
            direction LR
            A4["4: koira"] -.- A5["5: haukkuu"] -.- A6["6: sohvalla"]
        end
        subgraph R3["Lause 3"]
            direction LR
            A7["7: auto"] -.- A8["8: ajaa"] -.- A9["9: pihaan"]
        end
        R1 ~~~ R2 ~~~ R3
    end

    L0 ==> Step["<b>Mitä tapahtuu jokaisessa kerroksessa? (hᵢ → hᵢ₊₁)</b><br/>1. Attention suhteuttaa vektorit toisiinsa<br/>2. Feed-Forward (f) muuntaa vektoria<br/>3. Residual-yhteys (g) säilyttää vanhaa tietoa"]

    Step ==> L40

    subgraph L40["2. Kerros 40: Abstraktit vektoriryppäät (h₄₀)"]
        direction TB

        subgraph BigCluster["LEMMIKIT JA SISÄTILA (Samankaltaiset vektorit)"]
            direction LR
            subgraph Sub1["Kissa-alue"]
                C1["• kissa<br/>• istuu<br/>• matolla"]
            end
            subgraph Sub2["Koira-alue"]
                C2["• koira<br/>• haukkuu<br/>• sohvalla"]
            end
            Sub1 ---|Lähellä toisiaan| Sub2
        end

        subgraph FarCluster["KULKUNEUVO JA ULKOILMA"]
            C3["• auto<br/>• ajaa<br/>• pihaan"]
        end

        BigCluster -.-|Kaukana toisistaan| FarCluster
    end
5. Todennäköisyysjakauma — mikä token tulee seuraavaksi?
Kun kerrokset ovat käsitelleet kontekstin, malli tuottaa todennäköisyysjakauman kaikista mahdollisista tokeneista:
Esimerkki: Seuraavan sanan valinta syvien kerrosten perusteella
Kun kerroksella 40 vektorit ovat ryhmittyneet ja koko tekstikonteksti (kissa istuu matolla, koira on sohvalla ja auto ajaa pihaan) on yhdistetty, malli laskee todennäköisyydet seuraavalle tokenille:
| Token (seuraava sana) | Todennäköisyys | Selitys |
|---|---|---|
| "haukkuu" | 0.58 | Koira reagoi pihaan ajavaan autoon |
| "juoksee" | 0.24 | Aktiivinen reaktio ulkotapahtumaan |
| "nukkuu" | 0.05 | Epätodennäköinen, koska auto saapui pihaan |
| "ajaa" | 0.01 | Ei sovi koiran toiminnaksi tässä kontekstissa |
Malli ei tee tietoisia päätöksiä, vaan laskee satojen kerrosten avulla kaikille tuntemilleen sanoille todennäköisyydet. Sanan valinta tapahtuu poimimalla yksi token tästä lasketusta jakaumasta onnenpyörän tavoin (näytteenotto).
6. Sampling — miten token valitaan?
Kun malli on laskenut todennäköisyydet jokaiselle sanalle, varsinainen poiminta tehdään sampling-menetelmällä. Se määrittää, kuinka tiukasti noudatetaan suurinta todennäköisyyttä ja kuinka paljon satunnaisuudelle annetaan tilaa:
Greedy (Ahne valinta): Järjestelmä valitsee aina kaikkein todennäköisimmän tokenin. Tulos on täysin deterministinen (sama syöte tuottaa aina täsmälleen saman vastauksen), mutta teksti voi muuttua toistavaksi tai tylsäksi.
Top-p (Nucleus sampling): Järjestelmä ryhmittelee todennäköisimmät sanat paremmuusjärjestykseen ja leikkaa hännän pois kun tietty raja (p) täyttyy. Token poimitaan satunnaisesti tämän laadukkaan kärkijoukon sisältä, mikä lisää luonnollista vaihtelua.
Temperature (Lämpötila): Parametri, joka skaalaa todennäköisyysjakaumaa ennen poimintaa: * Matala temperature (esim. 0.2): Terävöittää eroja. Korkean todennäköisyyden sanat saavat entistä suuremman painoarvon \(\rightarrow\) varma, looginen ja konservatiivinen teksti. * Korkea temperature (esim. 0.8): Tasoittaa eroja. Pienemmän todennäköisyyden sanat saavat suuremman mahdollisuuden toteutua \(\rightarrow\) luova, yllättävä tai jopa satunnainen teksti.
Käsitepankki: Näytteenottomenetelmät (Sampling)
- Sampling (Näytteenotto): Tapa, jolla järjestelmä poimii seuraavan tokenin lasketusta todennäköisyysjakaumasta (painotettu satunnaisuus).
- Temperature (Lämpötila): Parametri, joka muokkaa todennäköisyysjakauman muotoa ennen poimintaa (tasoittaa tai terävöittää eroja).
- Top-p (Nucleus sampling): Menetelmä, joka rajaa poiminnan vain niihin sanoihin, joiden yhteistodennäköisyys saavuttaa tietyn kynnyksen (esim. parhaat 90 %).
7. Koko prosessi tiivistettynä
flowchart TD
    %% Tyylimäärittelyt
    classDef inputStyle fill:#e1f5fe,stroke:#0288d1,stroke-width:2px,color:#01579b;
    classDef processStyle fill:#f3e5f5,stroke:#8e24aa,stroke-width:2px,color:#4a148c;
    classDef mathStyle fill:#fff3e0,stroke:#f57c00,stroke-width:2px,color:#e65100;
    classDef outputStyle fill:#e8f5e9,stroke:#388e3c,stroke-width:2px,color:#1b5e20;
    classDef loopStyle fill:#fce4ec,stroke:#d81b60,stroke-width:2px,color:#880e4f;

    subgraph InputStage["1. Syötteen käsittely"]
        A["Teksti<br/><b></b> 'Kissa istuu matolla, koira...'"]:::inputStyle --> B["Tokenit<br/>[102, 405, 891, 103...]"]:::inputStyle
        B --> C["Vektorit<br/>[0.12, -0.85, 0.43...]"]:::inputStyle
    end

    subgraph LayerStage["2. Kerrokset & Vektoriavaruus"]
        C --> D["Attention suhteuttaa<br/> Koira liittyy autoon ja pihaan"]:::processStyle
        D --> E["Kerrokset muokkaavat vektoreita<br/> Lemmikki- ja piha-klusterit"]:::processStyle
    end

    subgraph OutputStage["3. Ennustus & Näytteenotto"]
        E --> F["Malli tuottaa todennäköisyysjakauman<br/> 'haukkuu': 58 %, 'juoksee': 24 %"]:::mathStyle
        F --> G["Valitaan / poimitaan seuraava token<br/> Poimitaan 'haukkuu'"]:::outputStyle
    end

    subgraph LoopStage["4. Autoregressiivinen silmukka"]
        G --> H{"Onko teksti valmis?"}:::loopStyle
        H -- "Ei" --> I["Lisätään token syötteeseen<br/> '...koira haukkuu'"]:::loopStyle
        I -.-> A
        H -- "Kyllä" --> J["Valmis vastaus"]:::outputStyle
    end
LLM ei siis “ymmärrä” tekstiä — se optimoi vektoreita ja laskee todennäköisyyksiä.
8. Miksi tämä on tärkeää Claude Codessa?
Claude Code suorittaa monimutkaisia ohjelmistokehityksen tehtäviä automaattisesti:
- Lukee projektin tiedostoja ja hahmottaa koodikantaa
- Analysoi kontekstia ja tunnistaa riippuvuuksia
- Tekee suunnitelmia arkkitehtuurimuutoksille
- Valitsee työkaluja (kuten
bash,gittai tiedostoeditori) - Tuottaa koodia ja kirjoittaa uusia toiminnallisuuksia
- Korjaa virheitä ajo- ja testiaikaisten logien perusteella
Koska koko tämä ketju perustuu LLM:n matemaattiseen ennustamiseen ja todennäköisyyspohjaiseen näytteenottoon — ei tietoiseen harkintaan tai inhimilliseen päättelyyn — järjestelmän ympärille tarvitaan tiukat suojamekanismit.
Malli ei "tiedä" tekevänsä virhettä tai ajavansa vaarallista komentoa, vaan se poimii seuraavan toiminnon todennäköisyysjakaumasta kontekstin perusteella.
Ennustettavuuden ja turvallisuuden hallinta
Jotta todennäköisyyksiin pohjaava järjestelmä pysyy turvallisena ja hallittavana tuotantoympäristössä, käytetään seuraavia rakenneratkaisuja:
| Mekanismi | Tehtävä ja merkitys |
|---|---|
| Determinismi (Hooks & Permissions) | Ennustamattoman näytteenoton rajoittaminen. Varmistetaan kriittisten komentojen ajaminen aina vahvistuksen tai kiinteiden sääntöjen kautta. |
| Eristys (Sub-agents) | Monimutkaisten tehtävien jakaminen erillisiin alakokoonpanoihin, jotta yksittäisen harha-ennusteen vaikutusalue jää mahdollisimman pieneksi. |
| Rajatut oikeudet | Minimoidaan vahinkopotentiaali (vastaavasti kuin tekoälyn näytteenoton rajat eli Top-p rajataan). Kielletään pääsy järjestelmän kriittisiin osiin ilman eksplisiittistä lupaa. |
| Kontekstin hallinta | Ennustelaadun ylläpito. Siivotaan irrelevantti tieto syötteestä, jotta Attention-mekanismi ei kiinnitä huomiota väärään tietoon ja nosta virheellisten ratkaisujen todennäköisyyksiä. |
Käsitepankki: Autonomisten LLM-agenttien turvallisuus
- Deterministinen hakanen (Hook): Ulkopuolinen koodisääntö, joka tarkistaa ja pysäyttää mallin ehdottaman toiminnon ennen sen suorittamista.
- Konteksti-ikkunan puhdistus: Tarpeettoman historian karsiminen, jolla estetään mallin ajautuminen "hallusinaatiokierteeseen" pitkissä koodaussessioissa.
- Sub-agentit: Erikoistuneet LLM-instanssit, joilla on vain tietty osatehtävä ja tiukasti rajatut lukuoikeudet.